AI 工作流
简历生成工作流
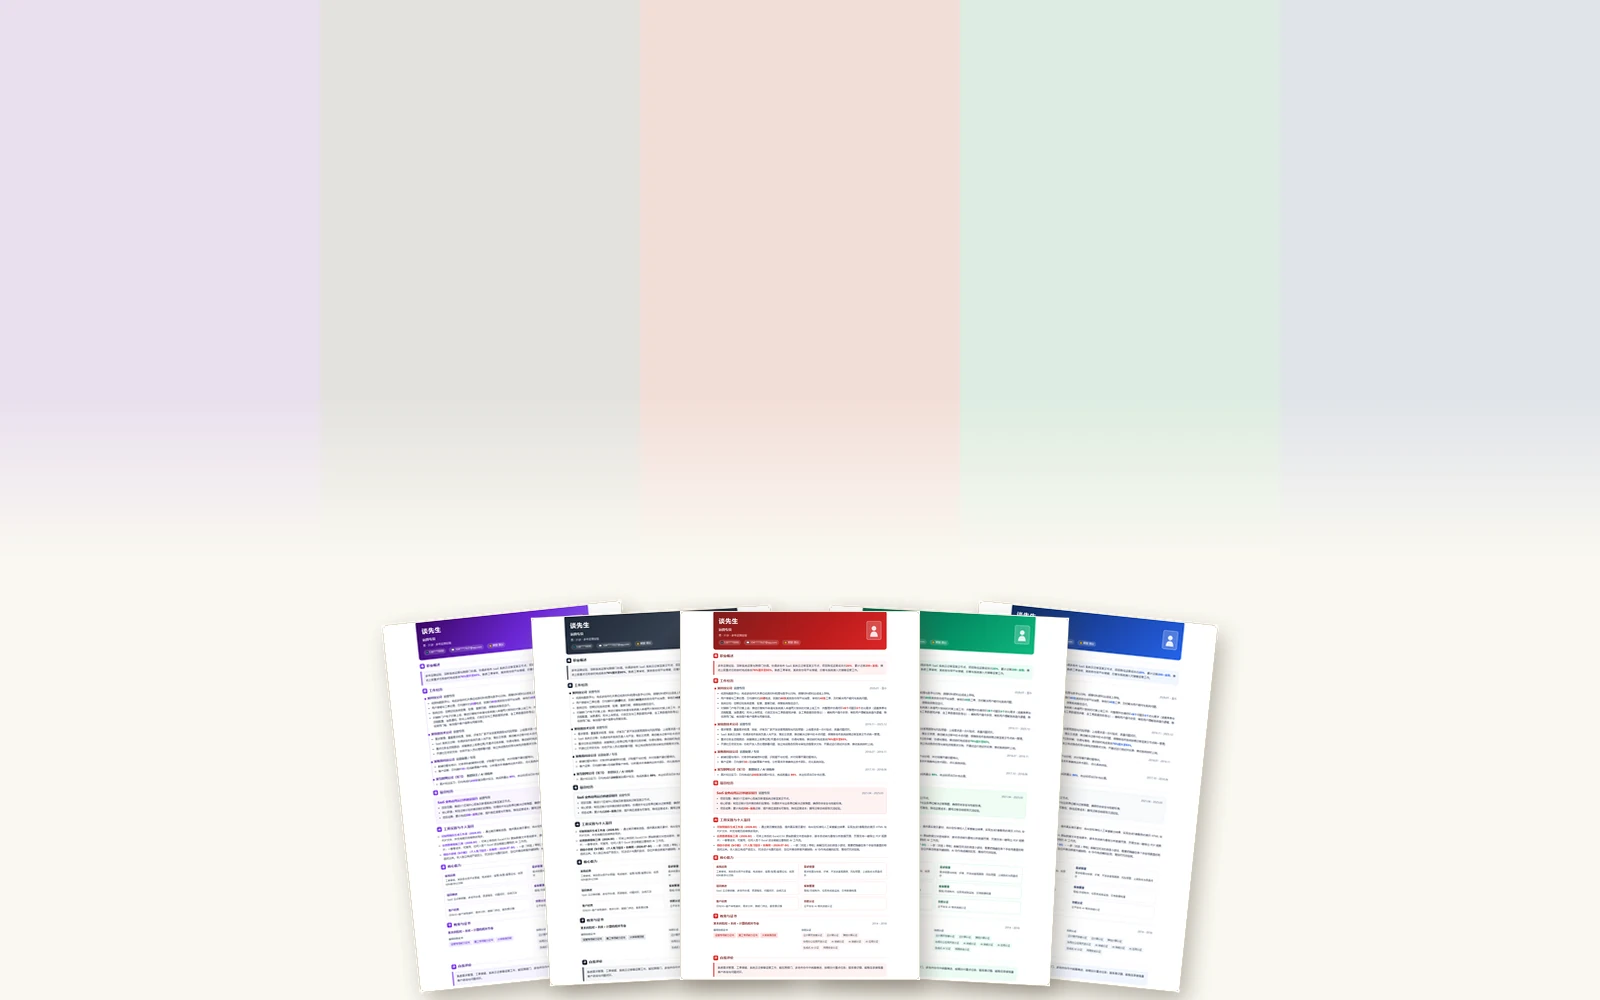
设计「单一内容源 + 一键多端输出」,一次改字同步生成 5 套配色,并为输出定下质检红线
PROJECT FACTS
项目事实
先看基本盘:谁做的、做了多久、做到什么程度。
- 我的角色
- 需求定义 · 标准制定 · 结果验收(技术实现由 AI 协同完成)
- 时间区间
- 2026.08.03 – 08.21
- 项目状态
- 已自用 · 持续迭代
- 分类
- AI 工作流
- 最后更新
- 2026-09-12
- 项目范围
- 目标与边界定义:方向、页数、薪资区间、措辞口径、禁忌词一次定死
- 单一内容源架构:一份内容源 → 一键输出 5 套配色 × HTML/PDF
- 事实源注入:以真实工作文档为素材,杜绝 AI 编造
- 质检红线:2 页以内、无乱码、无残留标签、ATS 友好
- 经验回写:每轮踩的坑沉淀成可复用清单,同样的错不犯第二次
- 能力标签
信息边界
本页数据来自项目 2026.08.03–08.21 的工作日志与产物清单,可逐条核对。 其中「8 轮迭代」「12 条经验」为过程记录,不构成绩效承诺; 「2 页以内、ATS 友好」是当时为该简历设定的验收标准,不代表通用规范。 技术实现(HTML/CSS 代码、PDF 渲染)由 AI 协同完成,我负责的是定义、标准与验收。
KEY NUMBERS
关键数字
每个数字都标了口径与来源,可核对。
METHOD / EVIDENCE
过程与依据
背景、我做了什么、关键决策、结果与复盘。
背景
当时手上只有一份内容反复改、版式反复调的简历,每换一个配色或改一个字,都要重排一遍,改一次错一次。 真正的问题不是「简历不好看」,而是没有单一事实来源:内容、版式、导出三者互相牵制。
我在里面做什么
① 定需求与选型。 一开始就把边界定死——目标方向、页数上限、薪资区间、措辞口径、禁忌词。 目标不清晰,AI 的执行力只会把跑偏放大。
② 给事实。 这是最关键的一步。我把真实的工作文档(工单问题汇总、待解决问题清单)作为素材喂进去, 让写出来的每一条都有据可查。防 AI 幻觉最实用的办法不是反复叮嘱「不要编」,而是让它没机会编。
③ 定标准。 给 AI 立规矩:全篇用「协调 / 统筹推进」,禁用「主导」;删掉「完整运营链路」「乐于学习」 这类套话;数字与单位之间不加空格;交付必须 2 页以内、无乱码、ATS 友好。
④ 审结果。 8 轮迭代,每一轮的验收都是我做的。我不看代码,但我看结果——标题重复、 口径打架、板块失衡、溢出一页,这些 AI 自己不会觉得有问题。
⑤ 沉经验。 每次踩坑都回写成一条经验,累计 12 条,沉淀进可复用的技能文档里。
关键决策:把「内容」和「版式」拆开
项目中途我做了一个架构级判断:删掉 Word 版,改为以 HTML 作为唯一内容源。 理由很简单——只要内容只有一份,配色和导出格式就都是「参数」,加一套配色只改一个参数,不动内容。
这个决定当时看起来只是省事,后来证明它决定了项目能不能继续扩展。
结果
- 一次改字,同步生成 5 套配色 × HTML/PDF = 10 份输出文件
- 8 轮内容迭代 + 3 轮工作流改造,全部逐轮验收
- 沉淀 12 条可复用避坑经验,同样的错不再犯第二次
边界与复盘
- 这是一份个人简历的生成流程,不是通用产品,没有对外发布,也不追求普适性
- 我没有训练模型、没有调参数。我做的是提示词与协作流程设计、人工反馈闭环、知识沉淀, 也就是让 AI 的输出可控、可验收、可复用
- 复盘里最有价值的一条是 08-21 那次:HTML 和 PDF 对不上,我要求以 PDF 为准重建, 排查时才发现 HTML 里混进了浏览器插件注入的约 800 字垃圾代码。 看起来「只是格式问题」,根因却在数据源被污染——这件事让我更确信: 输出对不上时,先查源头,别急着修表面
TIMELINE
时间线
按日期串起的推进过程。
- 08-03先定边界,再动笔
定保守润色方向、7–12K 薪资区间、一页半精华版。把边界一次定死,AI 就不会自由发挥跑偏。
- 08-04主动要求列优化清单
不要 AI 直接改,先出问题清单。勾出 4 个硬伤:标题重复、措辞口径打架、项目角色是废话、自我评价太短。
- 08-05拍板删 Word 版,改「单一内容源」
判断 docx 这条路没意义,改为一套内容源。这是架构级决定,直接决定了后来能一键出 5 套配色。
- 08-056 条 AI 化表达逐条定去留
主动砍掉「做事细致、责任心强」这类谁都能套的空话。
- 08-05主动降级表述,求真实
把「数据驱动策略优化」改成「日常数据梳理」、「技术素养」改成「技能认证」——宁可说小,不说大。
- 08-19 → 08-20推翻前一天的自己
上线一天发现 HTML 编辑不顺手,第二天推翻前一天的方案,改以 HTML 为编辑源。按真实反馈迭代决策,不硬撑。
- 08-21发现 HTML 与 PDF 对不上
要求以 PDF 为准重建。排查时发现 HTML 里混进了浏览器插件注入的约 800 字垃圾代码。
- 08-21压回 2 页,但绝不压字号
新增内容导致溢出,按「压缩旧内容、绝不压字号」的原则压回 2 页,共省约 96 字,零实质信息损失。
SOURCES
来源
本页结论的出处,逐条列出。
- 项目工作日志(2026.08.03 – 08.21)内部文档,未公开
- html-resume-pdf 技能文档与 12 条避坑清单内部文档,未公开
- 《电子印章服务接入问题汇总 V1》《待解决问题》本项目所引用的真实工单素材来源,内部文档,未公开
CHALLENGE & RESPONSE
可能的追问,以及我的回答
这到底是你做的,还是 AI 做的?
核心判断和验收是我的,代码执行是 AI 做的。我没有编程背景,所以我的价值不在写代码, 而在于我知道要什么、什么是对的、什么不能用。就像带一个新人——我把标准定清楚、素材给足、 最后逐条验收。这套方法我也能迁移到别的业务上。
你怎么防止 AI 瞎编内容?
两招。一是喂真实素材:把它要写的内容对应的原始工作文档给它,让它基于事实写; 二是定验收标准:不许夸大、数字必须来自我提供的材料,写完后我逐条核对。 简历里「49 个问题、8 个优化需求」这些数字,全部来自我的真实工单记录。
为什么不直接用 AI 生成,要迭代 8 轮?
因为第一版有夸大表述,也有 AI 套话。我每一轮只挑一个问题让它改,并要求它把教训记下来, 下次不再犯。与其一次要个 60 分的成品,不如用 8 轮做到能交付——这也是我做运营的习惯, 交付前必须验收。
这个项目跟运营岗有什么关系?
用的是同一套能力:把模糊需求拆成明确标准、协调资源推进、最后验收闭环。 而且我会主动用 AI 工具提效,能帮团队把重复性的文档和数据工作自动化。