个人项目
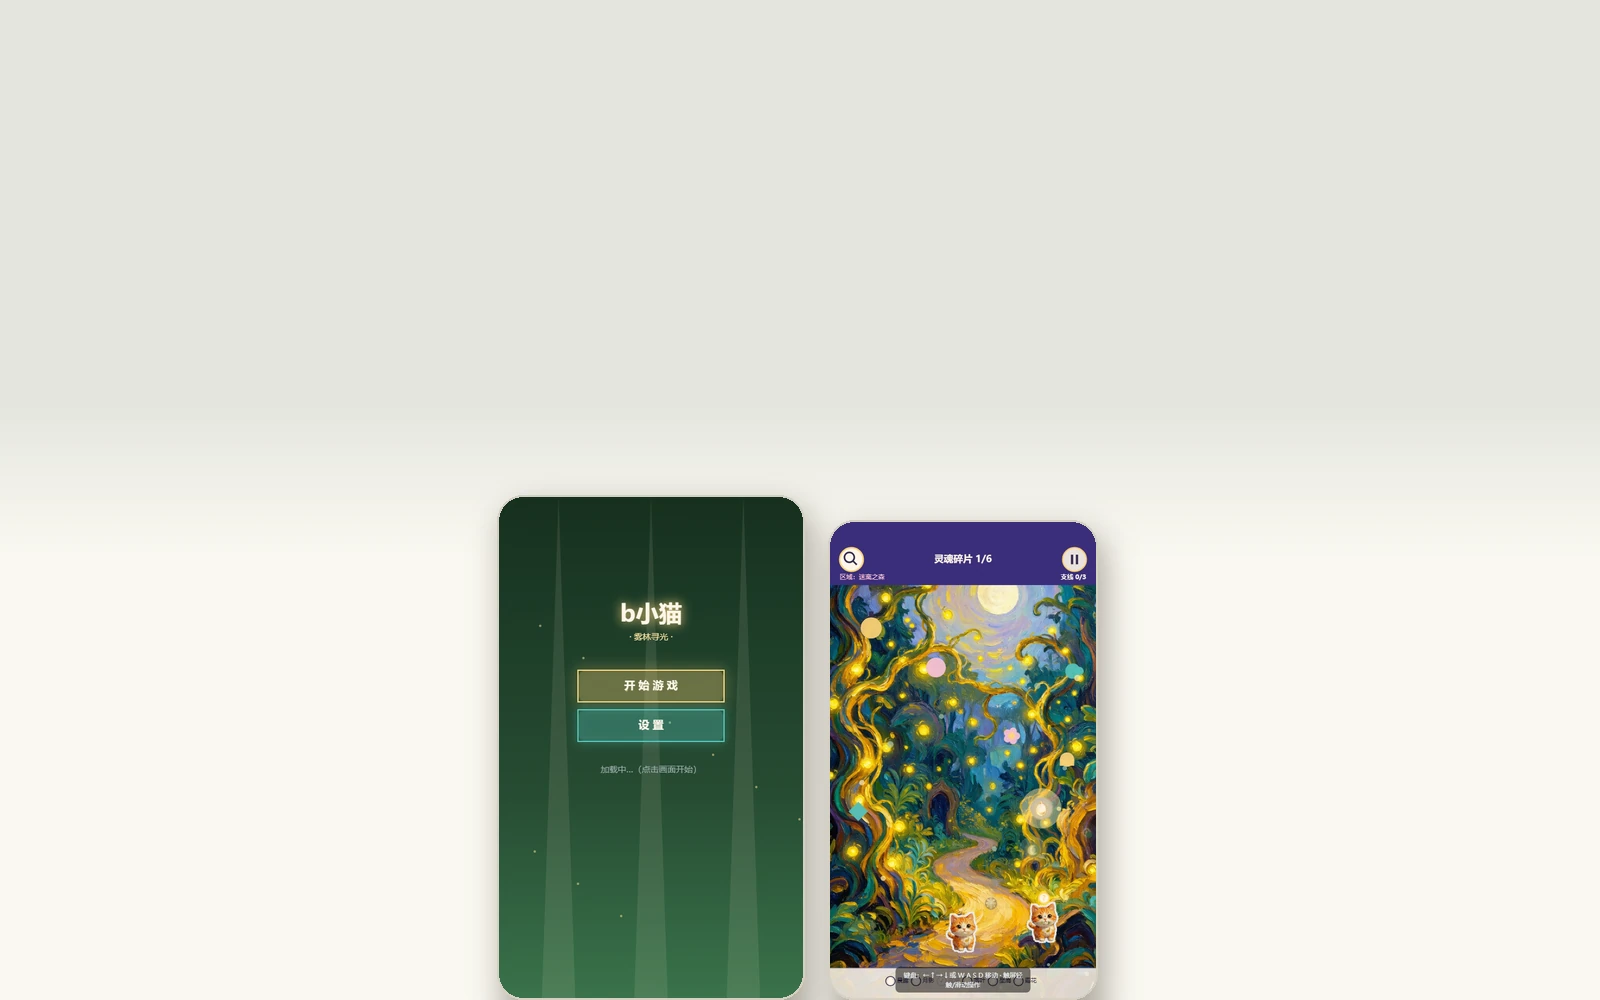
微信小游戏《b小猫》
独立完成产品定义、玩法与规则设计、真机验收,AI 协同完成编码实现,落地可玩体验版
PROJECT FACTS
项目事实
先看基本盘:谁做的、做了多久、做到什么程度。
- 我的角色
- 产品定义 · 玩法与规则设计 · 质量验收(编码由 AI 协同完成)
- 时间区间
- 2026.07.16 – 08.02
- 项目状态
- 可玩体验版 · 非商用
- 分类
- 个人项目
- 最后更新
- 2026-09-12
- 项目范围
- 产品定义:定位「找茬 / 寻物」类解压玩法,明确目标手感与难度曲线
- 规则与数值:星级算法、图鉴收录范围、成就阈值、难度档位逐条拍板
- 质量验收:真机复现缺陷并定位根因——这部分 AI 测不了,必须人来做
- 流程编排:设计角色分工 SOP 与质量关卡,由 AI 按序扮演执行
- 文档体系:项目文档与验收记录同步维护,不让文档落后于实现
- 能力标签
信息边界
这是一个**个人练习项目,非商用**,玩法参考 PC 端同类作品,仅用于学习与验证流程。 本页所有数字来自项目文档与测试脚本,其中「458 项自动化用例」为 2026-09-12 实际复跑结果,可当场重现。 **技术实现(代码)由 AI 协同完成**;我负责的是产品定义、玩法与规则设计、验收标准制定和真机验收。 项目中的角色分工是我设计的一套流程,由 AI 按序扮演,**不是真人团队**。
KEY NUMBERS
关键数字
每个数字都标了口径与来源,可核对。
METHOD / EVIDENCE
过程与依据
背景、我做了什么、关键决策、结果与复盘。
这个项目在做什么
一款「找茬 / 寻物」类的微信小游戏,玩法是把隐藏在手绘场景里的物品找出来。 它其实不只是「做了个小游戏」,而是我一个人加 AI,跑通了一条完整的产品交付链路: 需求定义 → 规则设计 → 开发执行 → 质量验收 → 方法沉淀。
我在里面做什么
① 产品定义与决策拍板。 需求池共 28 项,含与原作的内容差距分析。 我自己实跑后提反馈——比如「藏物太显眼、集齐太简单」,当场推动难度系统重构; 7 月 22 日把 21 项默认决策逐条确认定稿(星级算法、图鉴收录范围、成就阈值、彩蛋、难度档位等)。
② 规则与数值定死。 规则不定清楚,AI 就会按「平均情况」发挥,做出来的手感一定不对。 所以冷却时长、三档难度的时长、伪装强度这些,我全部给出具体数值,不留余地。
③ 质量验收与缺陷定位——这是 AI 测不了的部分,也是我最强的一项。
- 一开始就识别到测试环境没有渐变 API,主动标记 7 项视觉风险必须真机复核。 我知道「AI 说通过」不等于真的没问题。
- 7 月 28 日真机发现 4 处 UI 布局问题:标题屏文字压按钮、返回按钮重叠、 设置页露出游戏内 HUD、成就列表 17 条只显示 12 条。
- 7 月 29 日在真机上把 4 个布局与适配问题逐项闭环。
- 最值得说的是「碎片看不到、点不到」:我连续多轮复现、提供截图, 先后否掉了 AI 给出的三个错误方向,最终逼出真正根因—— 存档里「已找到列表已含 6 枚、但计数错位为 0」的不一致态。
- 8 月 1 日对比原作复查,一次揪出三个不合理改动:画质设置是假的(只影响标题屏、 游戏内不生效)、装饰物点了没反应、难度系统被整段删掉。
- 8 月 2 日发现「支线物品提前画在背景上」的剧透问题,拍板改为「接任务前完全隐藏」。
④ 流程治理——我给 AI 定的规矩。 逐条确认机制(每条执行前先确认)、先讨论再定方案、测试全量用例必须全绿才可交付、 文档每次改动同步更新。另外我做了一个可扩展性判断:8 月 1 日提出游戏名与关卡名解耦, 因为「迷离之森」在原作里只是其中一个关卡名,后面还会新增关卡。
⑤ 方法与体系沉淀。 设计角色分工 SOP(产品 → 架构 → 开发 → 测试,带质量关卡), 由 AI 按序扮演;建立记忆与身份体系,让跨会话协作不断线。
结果
- 交付可玩体验版,458 项自动化用例全绿(54 个测试文件,0 失败)
- 需求池 28 项、默认决策 21 项逐条拍板
- 真机缺陷定位 4 处并闭环
- 沉淀 45+ 份项目文档与一套可复用的协作流程
边界与复盘
- 非商用,是个人练习项目;玩法参考 PC 端同类作品,未使用其任何素材
- 代码实现由 AI 协同完成,我负责产品定义、规则设计、标准制定与验收
- 项目里的角色分工是我设计的流程、由 AI 扮演,不是真人团队
- 复盘:这个项目最值钱的不是游戏本身,而是那套「我定标准、AI 执行、我验收」的流程。 它让我确认了一件事——AI 不缺执行力,缺的是业务理解和标准
SOURCES
来源
本页结论的出处,逐条列出。
- 项目文档 45+ 份、项目日志 14 天内部文档,未公开
- 自动化测试脚本 tests/run.js可复跑验证,2026-09-12 实测 458 / 458 通过
- PC 端同类作品(玩法参照)公开作品,仅作玩法参照,未使用其任何素材
CHALLENGE & RESPONSE
可能的追问,以及我的回答
代码是你写的吗?
不是。我主导产品设计与 AI 协同落地,技术细节上我负责提需求、定验收标准、发现问题。 我没有编程背景,我的价值在于知道要什么、什么是对的、什么不能用。
那五个人是谁?
没有五个人。那五个角色(产品、架构、开发、测试)是**我设计的一套分工流程**, 由 AI 按顺序扮演,每一道卡口由我来验收。我做的其实是把一个模糊的想法, 拆成一条有卡口、有交付物的流水线。
为什么做个小游戏?跟运营岗有关系吗?
它是用来验证方法的载体。真要把它做好,需要的能力跟做运营是同一套: 定义需求、把规则和阈值定清楚、协调资源推进、发现问题并定位根因、最后验收闭环。 我把 AI 当成执行力很强、但不了解业务的新人下属——我定目标、给素材、定标准、做验收。
最大困难是什么?
最花时间的是「碎片看不到、点不到」那个问题。我连续多轮复现、提供截图, 先后否掉了 AI 给出的三个错误方向(画得太弱 / 坐标算错 / 图标问题), 最后才逼出真正根因——存档里「已找到列表已含 6 枚,但计数错位为 0」的不一致态。 期间我还否掉了 AI 加的调试标记,理由是原作没有这个东西。 这件事让我确认:**AI 说通过,不等于真的没问题**。